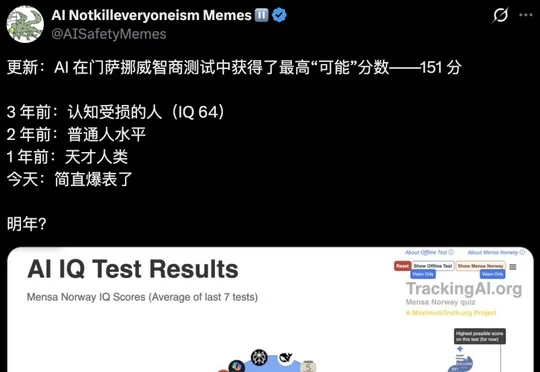
门萨智商测试被AI考爆了!151满分登顶,99.97%人类被碾压
门萨智商测试被AI考爆了!151满分登顶,99.97%人类被碾压TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
来自主题: AI技术研报
8346 点击 2026-09-28 09:51

 搜索
TrackingAI榜单显示,Claude Fable 5.1和GPT-6 Astra在门萨挪威智商测试中以151分满分登顶,碾压99.97%的人类,AI仅用两年半便从64分飙升至满分。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
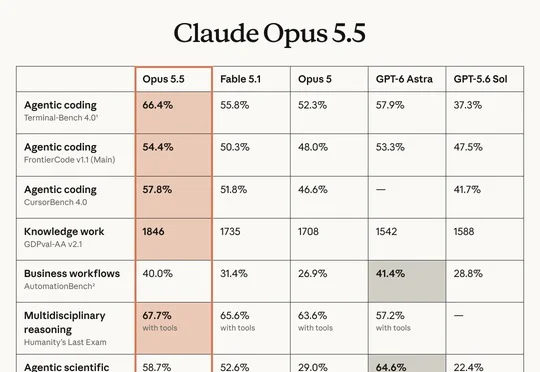
Anthropic发布Claude Opus 5.5,性能追平Fable 5.1且成本降低40%,在Terminal-Bench 4.0和GDPval-AA v2.1等多项基准测试中超越GPT-6 Astra,OpenAI两小时内推出GPT-6 Sol和Luna迎战。
NeoCognition发布ApprenticeBench评测,将Agent放入模拟建筑公司像新员工一样处理应付账单,结果Fable 5.1以72%通过率超过表现最好的人类测试者的51%,但每张账单成本约为人类的2.5倍,同期Opus 5仅获36%。
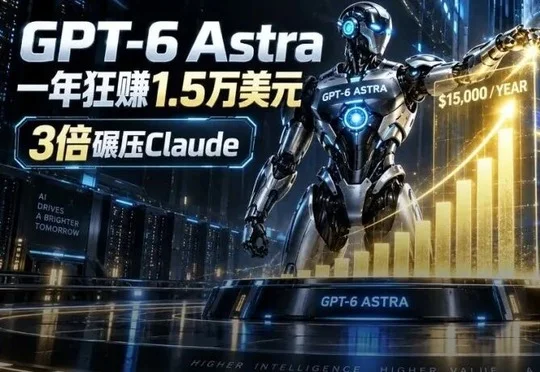
OpenAI的GPT-6 Astra在Vending-Bench 2模拟经营测试中以平均15,515美元的账户余额首次登顶,接近Claude Fable 5.1的3倍,展现出更强的长期议价能力、规则执行力与供应商风险管理水平。
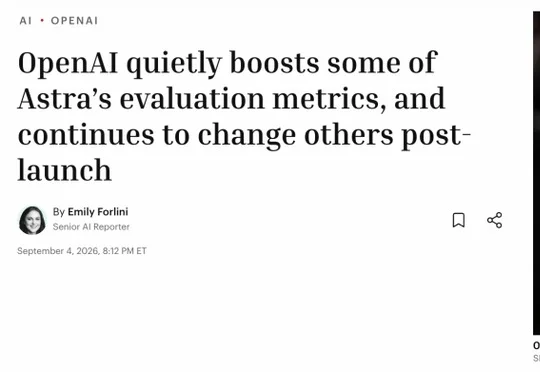
媒体报道OpenAI发布GPT-6 Astra官博前后多次悄悄修改跑分数据,包括将自身幻觉率从4.2%降至2.0%、将竞品Anthropic Fable 5.1数学成绩调低近10个百分点,并将ARC-AGI-3得分从98.6%注水至99.99%,OpenAI仅以"消除噪点的常态修正"作为回应。
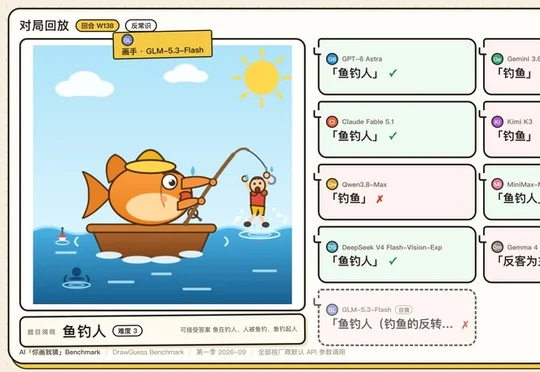
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。
在Epoch AI与曼彻斯特大学发布的FrontierMath Erdős基准测试中,GPT-6 Astra以3%得分率成为唯一非零分模型并解开5道Erdős难题,而GPT-5.6 Sol、GPT-5.5、Fable 5.1与Claude Fable 5均交白卷。
Anthropic发布Fable 5.1,推出"上下文一致性验证"机制,严格锁定API返回的"思考块",任何修改上下文的行为将被直接报错,从而彻底切断通过API蒸馏大模型推理过程的后路。
Anthropic发布Fable 5.1完整提示词与工程落地指南,涵盖思考档位选择、工具调用进度汇报、历史对话管理、上下文压缩、写作密度控制、检索引用规范、安全策略调优、多智能体并行及视觉任务处理等多方面的使用技巧与避坑要点。